Kiến thức
Các bài viết chuyên sâu về học máy, học sâu, xử lý ảnh, xử lý ngôn ngữ tự nhiên, thuật toán và toán học cao cấp.
Phục vụ các kỹ sư và nhà khoa học.
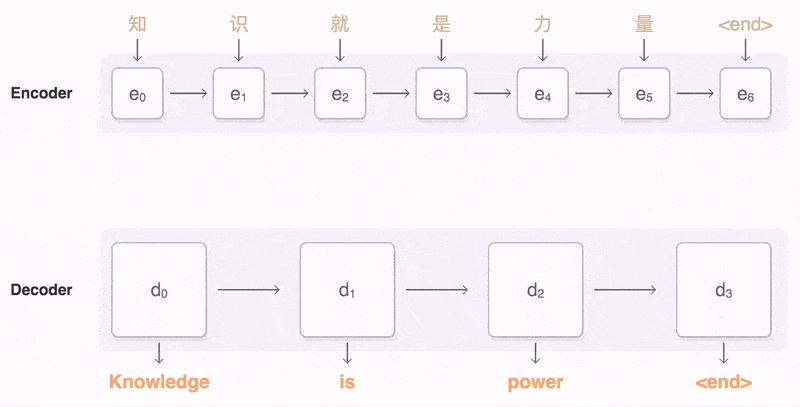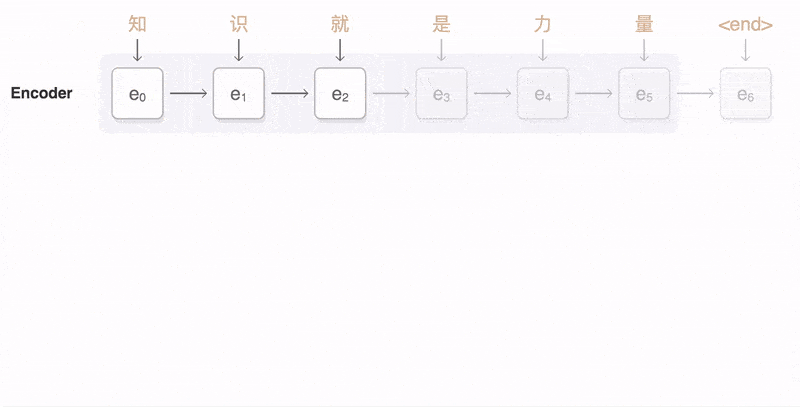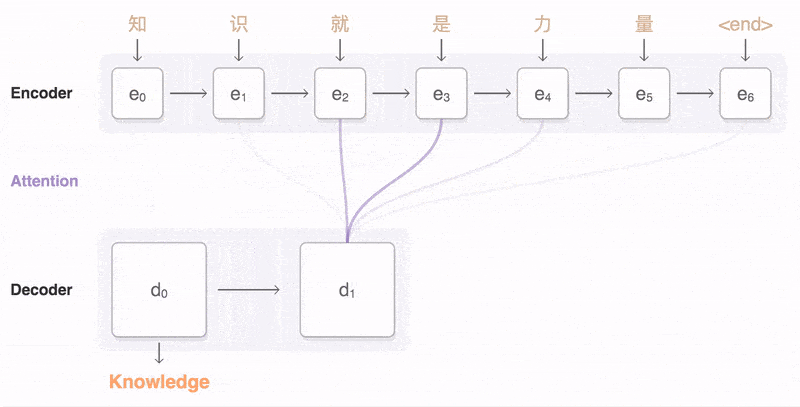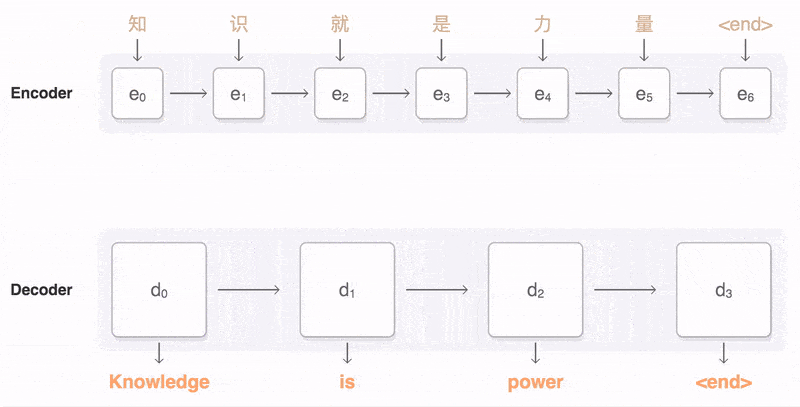
GAN – Mạng sáng tạo đối nghịch
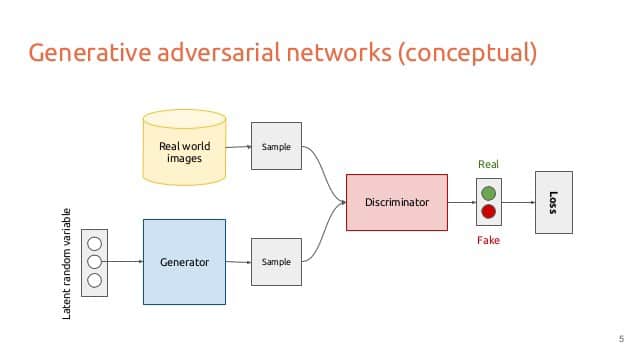
Mạng sáng tạo đối nghịch (Generative Adversarial Network) với tên ngắn phổ biến GAN là một lớp các mô hình sinh mẫu sử dụng các kiến trúc học sâu. Mô hình sinh là một bài toán trong học máy liên quan đến việc tự động phát hiện và học các mẫu phổ biến trong dữ … Đọc tiếp
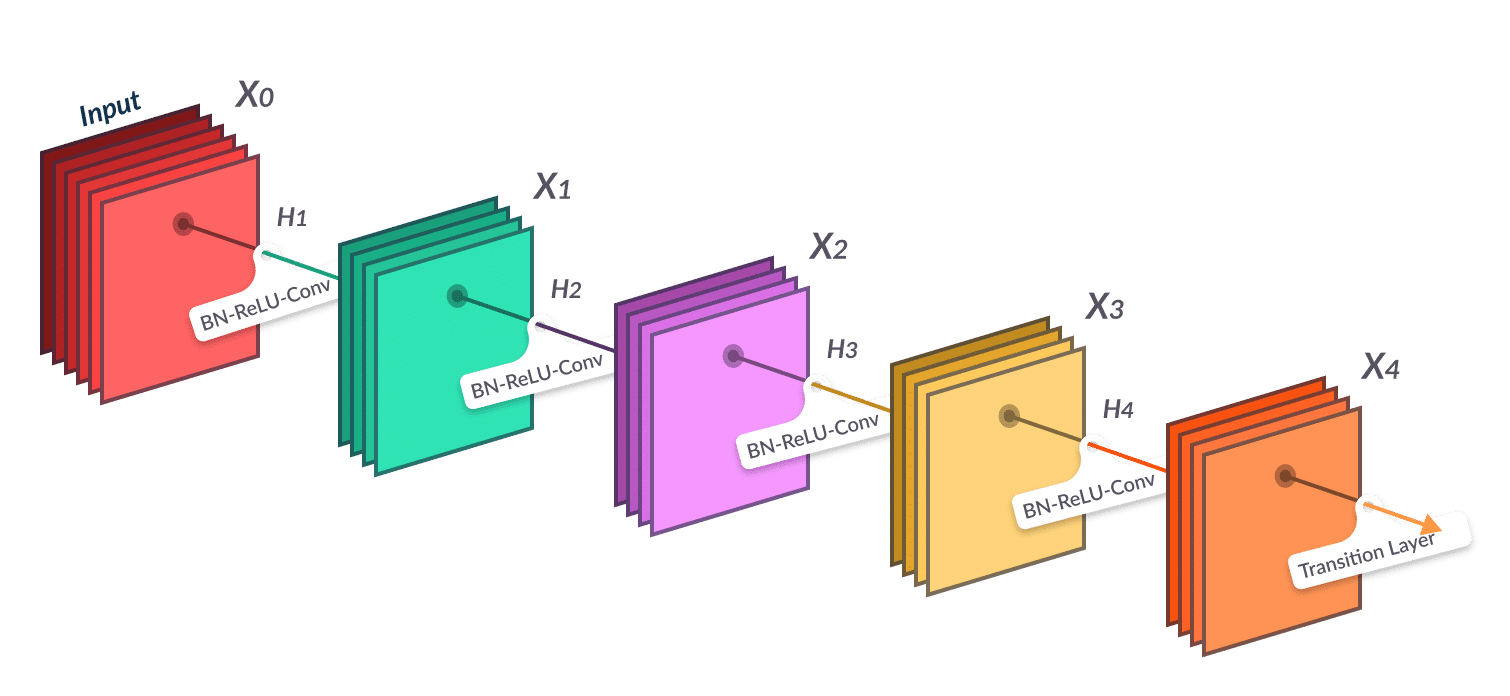
Deep Learning là gì?

Trong thời gian gần đây, deep learning là chủ đề nhận được sự quan tâm lớn trên thế giới và cả ở Việt Nam. Vậy deep learning là gì? Hãy cùng trituenhantao.io tìm hiểu qua bài viết ngắn dưới đây. Deep Learning là gì? Deep learning (học sâu) là một chức năng của trí tuệ … Đọc tiếp
Gradient trong Deep Learning là gì?
Tìm hiểu về Deep learning chắc hẳn các bạn sẽ gặp nhiều thuật ngữ đặc thù. Để có thể hiểu sâu sắc các khía cạnh kỹ thuật của Deep learning, bạn cần phải hiểu về Gradient (độ dốc) – một khái niệm trong tính toán không gian véc tơ. Gradient (độ dốc) là khái niệm … Đọc tiếp
XLNet – Người khổng lồ thay thế vị trí của BERT
Năm 2018, Google giới thiệu BERT, mô hình học sâu pre-trained lập kỷ lục với 11 kết quả state-of-the-art với các nhiệm vụ của Xử lý ngôn ngữ tự nhiên. Nó nhanh chóng nhận được sự quan tâm lớn của các nhà khoa học và công nghiệp trên toàn thế giới. Các công trình nghiên … Đọc tiếp
Thuật ngữ về Deep Learning cho “lính mới” – Phần 1
Nếu một người ở thế kỷ 20 không hiểu gì về điện thì khả năng họ sẽ gặp phải rất nhiều khó khăn. Tương tự như vậy ở thế kỷ 21, nếu bạn không biết đến sự tồn tại của Deep Learning thì bạn đang đánh mất một lợi thế cạnh tranh rất lớn. Nếu … Đọc tiếp
Phần 1: Phân loại Naive Bayes (Lý thuyết)
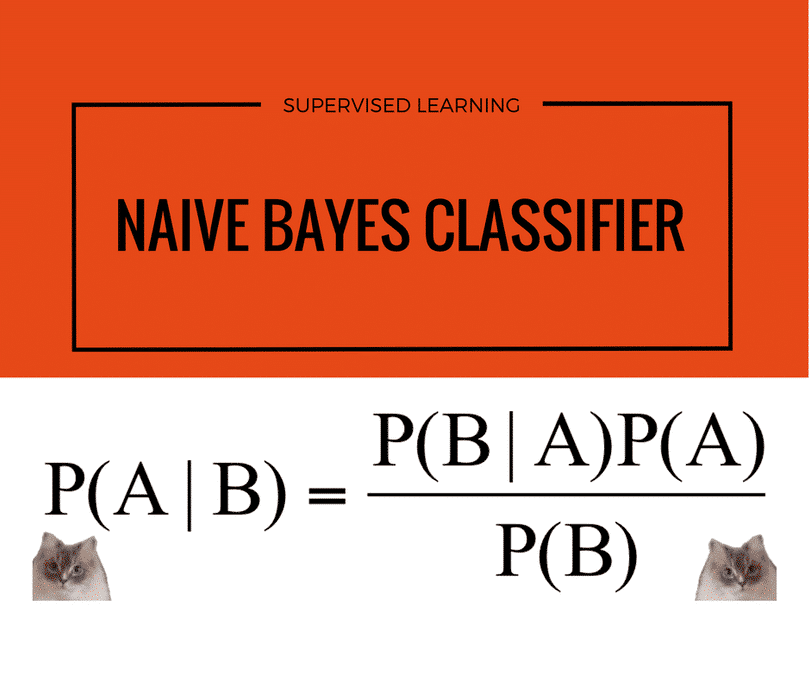
Trong bài này, tôi sẽ cùng các bạn tìm hiểu về thuật toán cơ bản của phương pháp Supervised Learning (Học có giám sát) là thuật toán phân loại Naive Bayes. Bài viết được chia làm hai phần: phần đầu ta sẽ cùng tìm hiểu cách thức hoạt động của thuật toán Naive Bayes và … Đọc tiếp
Sự thú vị của NLP – Phần 3
Qua phần 1 ta đã biết xử lý ngôn ngữ tự nhiên có thể hiểu đơn giản là ngôn ngữ của con người. Máy tính được lập trình để xử lý tốt đối với dữ liệu có cấu trúc như các bảng số hay database. Nhưng ngôn ngữ của con người lại được thể hiện … Đọc tiếp