Kiểm chứng giả thuyết (Hypothesis testing) là công cụ quan trọng để các nhà khoa học dữ liệu có được các kết luận tin cậy về mặt thống kê. Trong bài này, hãy cùng trituenhantao.io tìm hiểu kiểm chứng giả thuyết thông qua ví dụ đơn giản.
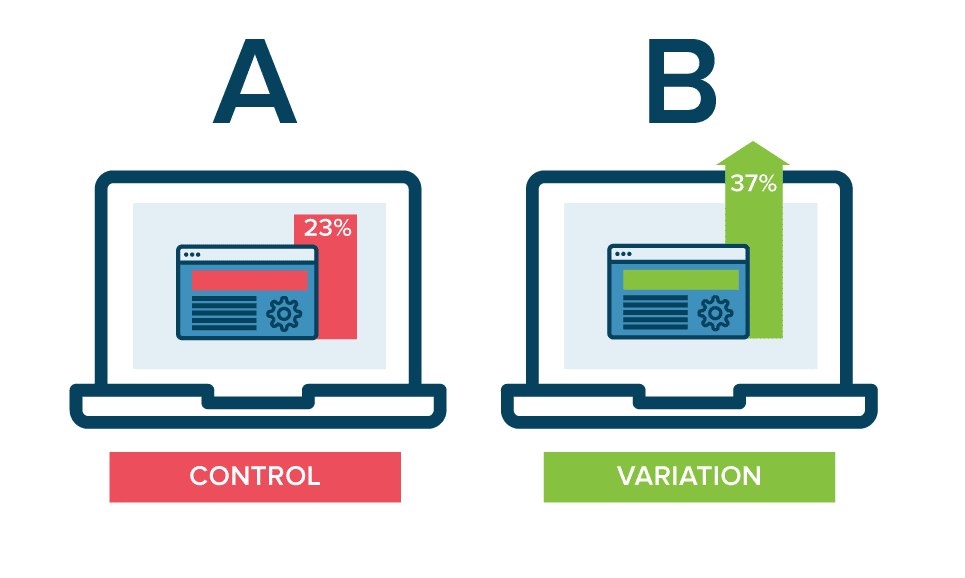
Cơ sở của kiểm chứng giả thuyết
Cơ sở của kiểm chứng giả thuyết là (a) Giả thuyết không – Null Hypothesis và (b) Giả thuyết nghịch – Alternative Hypothesis.
Các nhà thống kê sẽ bắt đầu với một góc nhìn bi quan trước và bắt đầu với Giả thuyết không. Họ sẽ tính một con số thống kê kiểm định (test statistic) với công thức như sau:
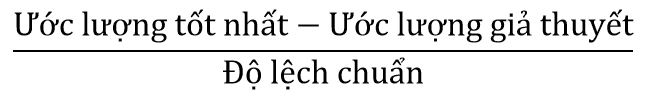
Ở công thức này, ước lượng tốt nhất được tính từ trung bình mẫu hoặc một tổ hợp từ mẫu. Độ lệch chuẩn biểu thị mức độ biến động của ước lượng này và bị ảnh hưởng bởi phương sai và kích thước mẫu.
Sau đó, họ hỏi một câu hỏi đơn giản
“Xác suất để có thể quan sát được con số này là bao nhiêu, liệu con số này có tuyệt đối ngẫu nhiên hay không (nói cách khác là giả thuyết không có đúng hay không)?”
Xác suất để có thể quan sát được con số này được gọi là p-value. Xác suất này được tính trên giả định của một phân phối xác suất nào đó (thường là phân phối chuẩn).
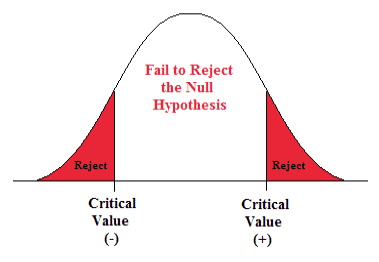
Giả thuyết không là một giả thuyết nhàm chán, nó giả định rằng không có gì thú vị xảy ra cả, tất cả đều chỉ là ngẫu nhiên.
Giả thuyết nghịch là giả thuyết ngược lại với giả thuyết không, nó cho rằng các quan sát / hiện tượng và các con số thống kê có thể cho chúng ta hiểu biết sâu sắc về một khía cạnh nào đó chứ không đơn thuần là một sự tình cờ.
Bạn thay một nút mua hàng trên website. Sau thử nghiệm, trang cũ có tỷ lệ mua 10%, còn trang mới đạt 13%. Nhìn vào hai con số này, rất dễ kết luận rằng thiết kế mới hiệu quả hơn.
Nhưng nếu mỗi trang chỉ có vài chục người truy cập thì sao? Liệu chênh lệch đó phản ánh một cải thiện thật, hay hai nhóm tình cờ có những khách hàng khác nhau? Nếu làm lại thử nghiệm, kết quả có thể đổi chiều không?
Kiểm chứng giả thuyết, thường gọi là kiểm định giả thuyết trong thống kê, giúp chúng ta đánh giá một nhận định bằng dữ liệu, trong khi vẫn tính đến biến động ngẫu nhiên.
1. Kiểm chứng giả thuyết thực sự trả lời câu hỏi nào?
Hypothesis testing là tên tiếng Anh của kiểm chứng giả thuyết. Đây là cách dùng dữ liệu mẫu để đánh giá một phát biểu cụ thể về tổng thể hoặc về quá trình tạo ra dữ liệu.
Chẳng hạn, bạn muốn biết tỷ lệ mua hàng của tất cả khách hàng có thay đổi khi dùng giao diện mới hay không. Bạn không thể quan sát mọi khách hàng hiện tại và tương lai. Bạn chỉ có dữ liệu của những người tham gia thử nghiệm.
- Population, tổng thể: nhóm đối tượng mà bạn muốn tìm hiểu và đưa ra kết luận.
- Sample, mẫu: những đối tượng thực sự được quan sát.
- Parameter, tham số: đại lượng của tổng thể cần tìm hiểu, chẳng hạn tỷ lệ mua thật sự.
- Statistic, thống kê mẫu: đại lượng tính từ mẫu, chẳng hạn 130 người mua trong 1.000 người, tương ứng 13%.
Hai mẫu lấy từ cùng một tổng thể có thể cho hai tỷ lệ khác nhau. Vì vậy, thấy chênh lệch trong mẫu chưa đủ để kết luận rằng tổng thể có chênh lệch. Nền tảng của suy luận này được trình bày trong hướng dẫn về ước lượng và kiểm định của NIST.
Kiểm định bắt đầu bằng một giả định cụ thể. Sau đó, chúng ta hỏi: Nếu giả định này đúng và mô hình thống kê phù hợp, dữ liệu như đã quan sát có bất thường đến mức cần xem xét lại giả định không?
Phương pháp này không loại bỏ mọi sự không chắc chắn. Nó giúp chúng ta đánh giá bằng chứng theo một quy tắc rõ ràng, thay vì kết luận chỉ vì một con số trông có vẻ lớn.
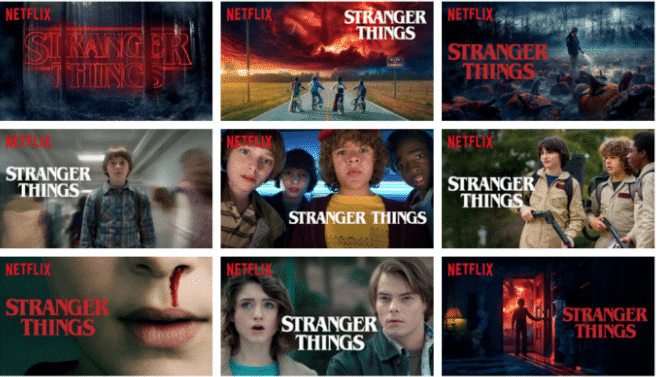
Nếu bạn từng xem phim trên Netflix, bạn chắc chắn đã tham gia vào một hình thức của kiểm chứng giả thuyết mang tên A/B testing.
Netflix hiển thị cùng một chương trình với các thiết kế khác nhau cho các nhóm người dùng khác nhau. Phản ứng của người dùng (như click, không click, xem, quay trở lại) được thu thập và phân tích với phương pháp kiểm chứng giả thuyết.
2. Hiểu đúng giả thuyết không và giả thuyết nghịch
Một kiểm định thường đặt hai phát biểu cạnh nhau: Null hypothesis, giả thuyết không, ký hiệu H0, và Alternative hypothesis, giả thuyết nghịch (giả thuyết đối), ký hiệu H1 hoặc Ha.
H0 là phát biểu được dùng làm cơ sở để tính toán. H1 mô tả khả năng thay thế mà kiểm định muốn phát hiện. Cách đặt này được giải thích trong tài liệu về kiểm định thống kê của NIST.
| Câu hỏi | H0 | H1 |
|---|---|---|
| Đồng xu có thiên về mặt ngửa không? | Xác suất ngửa không lớn hơn 50%. | Xác suất ngửa lớn hơn 50%. |
| Hai giao diện có tỷ lệ mua khác nhau không? | Hai tỷ lệ mua bằng nhau. | Hai tỷ lệ mua khác nhau. |
| Máy có rót trung bình đúng 500 ml không? | Thể tích trung bình bằng 500 ml. | Thể tích trung bình khác 500 ml. |
Hãy phân biệt phát biểu về tổng thể với con số trong mẫu. Trong thử nghiệm A/B, bạn đã biết hai tỷ lệ quan sát là 10% và 13%. Điều cần kiểm định là liệu hai tỷ lệ thật sự có bằng nhau hay không, dù các tỷ lệ mẫu khác nhau.
3. Ví dụ 1: Tung đồng xu để hiểu p-value
Đặt câu hỏi trước khi tung
Giả sử bạn nghi một đồng xu có xu hướng ra mặt ngửa nhiều hơn. Bạn quyết định trước rằng sẽ tung đúng 10 lần, các lần tung độc lập và xác suất ngửa giữ nguyên qua các lần tung.
Gọi p là xác suất ra mặt ngửa. Khi đó:
- H0: p ≤ 0,5.
- H1: p > 0,5.
Để tính p-value cho kiểm định này, ta dùng mốc biên p = 0,5. Trong những giá trị thuộc H0, đây là giá trị cho xác suất xuất hiện nhiều mặt ngửa lớn nhất.
Kết quả bạn thu được là 8 lần ngửa trong 10 lần tung. Tỷ lệ quan sát là 80%, cao hơn khá nhiều so với 50%. Nhưng 10 lần tung vẫn là một mẫu nhỏ.
Vì sao phải tính cả 8, 9 và 10 lần ngửa?
Nếu đồng xu có xác suất ngửa 50%, kết quả 9 hoặc 10 lần ngửa còn nghiêng về hướng bạn đang nghi ngờ nhiều hơn kết quả 8 lần. Vì vậy, p-value phải tính cả ba khả năng này.
| Kết quả | Số chuỗi kết quả tương ứng | Xác suất |
|---|---|---|
| Đúng 8 lần ngửa | 45 | 45 / 1.024 ≈ 4,3945% |
| Đúng 9 lần ngửa | 10 | 10 / 1.024 ≈ 0,9766% |
| Đúng 10 lần ngửa | 1 | 1 / 1.024 ≈ 0,0977% |
| Ít nhất 8 lần ngửa | 56 | 56 / 1.024 ≈ 5,4688% |
Có 210 = 1.024 chuỗi kết quả ngửa và sấp có thể xảy ra. Theo giả định trên, chúng có xác suất bằng nhau. Với đúng 8 lần ngửa, ta chọn hai vị trí xuất hiện mặt sấp trong 10 vị trí: 10 × 9 / 2 = 45 cách. Tương tự, đúng 9 lần ngửa có 10 cách, còn toàn bộ đều ngửa chỉ có một cách.
p-value = P(X ≥ 8 khi p = 0,5) = (45 + 10 + 1) / 1.024 = 0,0546875.
Ở đây, X là số lần ngửa. Con số 0,0546875 tương đương khoảng 5,47%.
Định nghĩa p-value bằng ngôn ngữ dễ hiểu
P-value là xác suất, tính theo H0 và các giả định của mô hình, để thu được một thống kê kiểm định cực đoan ít nhất như giá trị đã quan sát.
Trong ví dụ này, “cực đoan” có nghĩa là nhiều mặt ngửa. Vì thế, ta tính xác suất có từ 8 lần ngửa trở lên, chứ không chỉ xác suất có đúng 8 lần ngửa.
Nếu lặp lại rất nhiều đợt, mỗi đợt 10 lần tung với đồng xu công bằng và đúng cách lấy mẫu đã nêu, khoảng 5,47% số đợt sẽ có ít nhất 8 lần ngửa. Đây là cách đọc con số vừa tính.
Đừng đảo chiều câu hỏi: p-value không nói rằng đồng xu có 5,47% khả năng công bằng. Nó cũng không nói rằng có 94,53% khả năng đồng xu bị lệch. Hiệp hội Thống kê Hoa Kỳ nhấn mạnh rằng p-value không phải xác suất một giả thuyết đúng, cũng không phải xác suất dữ liệu chỉ do ngẫu nhiên tạo ra. Xem tuyên bố của ASA về p-value.
Tính bằng Python
Cài SciPy nếu môi trường của bạn chưa có thư viện này:
python -m pip install scipy
Với số lần ngửa và số lần tung đã biết, có thể dùng hàm binomtest của SciPy:
from scipy.stats import binomtest

result = binomtest(k=8, n=10, p=0.5, alternative="greater")
print(f"p-value = {result.pvalue:.6f}")
p-value = 0.054688
Trong đó, k là số lần ngửa, n là tổng số lần tung, p là xác suất theo mốc kiểm tra. alternative="greater" chỉ định rằng ta đang kiểm tra xu hướng lớn hơn mốc đó.
4. Mức ý nghĩa và hai loại sai lầm
Significance level, mức ý nghĩa, ký hiệu α và đọc là alpha, là ngưỡng được chọn trước để quyết định khi nào bác bỏ H0. Một lựa chọn thường gặp là α = 0,05. Mức này kiểm soát xác suất bác bỏ nhầm H0 khi H0 đúng, trong những điều kiện mà kiểm định được thiết kế để áp dụng. Xem giải thích về mức ý nghĩa của NIST.
- Nếu p-value ≤ α: bác bỏ H0 theo quy tắc đã chọn.
- Nếu p-value > α: chưa đủ bằng chứng để bác bỏ H0.
Ở ví dụ đồng xu, 0,0546875 > 0,05. Vì vậy, ta chưa bác bỏ H0 ở mức ý nghĩa 5%. Cách nói phù hợp là: “Với 10 lần tung, dữ liệu chưa đủ để kết luận xác suất ngửa vượt 50% ở mức ý nghĩa 5%”.
Nếu kết quả của một thử nghiệm riêng được ấn định trước là 9 lần ngửa trong 10 lần, p-value một phía sẽ là 11 / 1.024 ≈ 0,010742. Kết quả đó dẫn đến bác bỏ H0 ở mức 5%. Đây là hai tình huống minh họa riêng, không phải hướng dẫn tung thêm rồi dừng khi kết quả vừa đạt ngưỡng.
Sai lầm loại I và loại II
| Loại sai lầm | Điều xảy ra | Ví dụ với giao diện bán hàng |
|---|---|---|
| Type I error Sai lầm loại I | Bác bỏ H0 dù H0 đúng. | Kết luận hai giao diện có tỷ lệ mua khác nhau dù tỷ lệ thật sự bằng nhau. |
| Type II error Sai lầm loại II | Không bác bỏ H0 dù H0 sai. | Không phát hiện chênh lệch tỷ lệ mua dù hai giao diện thật sự khác nhau. |
Hãy hình dung kiểm định như một hệ thống báo động. Sai lầm loại I là báo động nhầm. Sai lầm loại II là bỏ sót điều đáng báo động.
Statistical power, công suất kiểm định, là xác suất phát hiện được một mức khác biệt cụ thể khi mức khác biệt đó thật sự tồn tại. Power bằng 1 − β, trong đó β là xác suất sai lầm loại II tại mức khác biệt đang xét. Khái niệm này được trình bày trong phần kiểm định của NIST.
Ví dụ, nếu thiết kế thử nghiệm có power 80% để phát hiện mức tăng từ 10% lên 13%, thì khi hai tỷ lệ thật sự là 10% và 13%, khoảng 80% những lần lặp lại đúng thiết kế sẽ phát hiện chênh lệch. Điều này không có nghĩa một kết quả riêng lẻ có 80% khả năng đúng.
Chọn α nhỏ hơn giúp hạn chế báo động nhầm, nhưng với cùng cỡ mẫu và cùng mức khác biệt thật, thường làm tăng nguy cơ bỏ sót. Bởi vậy, không có một ngưỡng duy nhất phù hợp với mọi quyết định.
5. Kiểm định một phía và hai phía
One-sided test, kiểm định một phía, tìm khác biệt theo một hướng đã xác định. Two-sided test, kiểm định hai phía, xét khác biệt theo cả hai hướng. Lựa chọn phụ thuộc vào câu hỏi nghiên cứu, không phụ thuộc vào kết quả bạn muốn có.
| Câu hỏi | Giả thuyết nghịch | Kết quả nào được tính là cực đoan? |
|---|---|---|
| Đồng xu có thiên về ngửa không? | p > 0,5 | Quá nhiều mặt ngửa. |
| Đồng xu có khác mức ngửa 50% không? | p ≠ 0,5 | Quá nhiều hoặc quá ít mặt ngửa. |
Với kết quả 8 lần ngửa trong 10 lần và mốc 50%, kiểm định hai phía tính cả các trường hợp có ít nhất 8 lần ngửa và các trường hợp có nhiều nhất 2 lần ngửa. P-value là 0,109375, gấp đôi 0,0546875 trong ví dụ một phía.
Việc nhân đôi ở đây đúng nhờ tính đối xứng của bài toán này. Không nên tự động áp dụng cách nhân đôi cho mọi kiểm định, đặc biệt với phân phối rời rạc không đối xứng.
Nếu thử một giao diện mới và cần phát hiện cả việc tăng lẫn giảm tỷ lệ mua, câu hỏi hai phía phù hợp với mục tiêu đó. Nếu có lý do xác định một hướng từ trước, có thể thiết kế kiểm định một phía. Không nên đợi thấy dữ liệu tăng rồi mới chọn phía tăng để có p-value nhỏ hơn.
6. Thống kê kiểm định và sai số chuẩn
Test statistic, thống kê kiểm định, là con số tóm tắt dữ liệu theo cách phục vụ việc kiểm tra H0. Với nhiều kiểm định z và t, nó có dạng:
Thống kê kiểm định = (Ước lượng từ mẫu − Giá trị theo H0) / Sai số chuẩn.
Tử số cho biết kết quả quan sát lệch khỏi mốc bao nhiêu. Mẫu số cho biết ước lượng có thể dao động đến mức nào do việc lấy mẫu. Cùng lệch 4 đơn vị, kết quả sẽ đáng chú ý hơn nếu sai số chuẩn là 1 thay vì 10.
Cần phân biệt hai thuật ngữ dễ nhầm:
- Standard deviation, độ lệch chuẩn, viết tắt SD: mô tả mức phân tán của các quan sát riêng lẻ.
- Standard error, sai số chuẩn, viết tắt SE: mô tả mức biến động của một ước lượng, chẳng hạn trung bình mẫu, qua những lần lấy mẫu.
Với trung bình của n quan sát độc lập, cùng phân phối và có phương sai hữu hạn, SE được ước lượng bằng s / √n, trong đó s là độ lệch chuẩn mẫu. Ví dụ, độ lệch chuẩn thể tích giữa các chai là 8 ml và ta lấy 25 chai thì SE của trung bình là 8 / √25 = 1,6 ml. Công thức kiểm định trung bình được trình bày trong hướng dẫn của NIST.
Tăng số chai giúp ước lượng trung bình chính xác hơn nếu cách lấy mẫu vẫn phù hợp. Nó không tự làm từng chai được rót đồng đều hơn. Đó là sự khác nhau giữa giảm SE của ước lượng và giảm SD của quá trình sản xuất.
Dạng công thức trên không áp dụng cho mọi kiểm định. Ví dụ, kiểm định nhị thức chính xác có thể tính trực tiếp xác suất từ số lần thành công, không cần biến đổi thành z.
Một cách ra quyết định khác là so thống kê kiểm định với critical value, giá trị tới hạn. Chẳng hạn, với kiểm định z dựa trên phân phối chuẩn chuẩn hóa, ở mức ý nghĩa 5%, kiểm định hai phía bác bỏ H0 khi z nằm ngoài khoảng xấp xỉ từ −1,96 đến 1,96. Nếu kiểm định một phía theo hướng tăng, ta bác bỏ H0 khi z vượt ngưỡng khoảng 1,645. Các ngưỡng này phụ thuộc vào phân phối, mức ý nghĩa và số phía của kiểm định, không phải những con số dùng chung cho mọi bài toán.
7. Ví dụ 2: Trang bán hàng mới có hiệu quả hơn?
A/B testing, thử nghiệm A/B, là cách so sánh hai phiên bản trong một thiết kế thử nghiệm. Ở đây, A là trang hiện tại, B là trang mới. Chúng ta muốn biết việc đổi trang có làm thay đổi tỷ lệ mua hàng hay không.
Bước 1: Thiết kế để phép so sánh có ý nghĩa
Giả sử bạn phân khách hàng ngẫu nhiên vào hai nhóm chạy đồng thời. Mỗi khách chỉ thuộc một nhóm, được tính một lần và có cùng khoảng thời gian theo dõi việc mua hàng. Trước khi chạy, bạn chọn tỷ lệ khách có ít nhất một lần mua làm chỉ số chính, chọn kiểm định hai phía với α = 0,05 và ấn định cách xác định cỡ mẫu, thời điểm kết thúc.
Đây là phần bạn có thể chủ động làm tốt: phân nhóm, đo lường, giữ cách tính nhất quán. Dù vậy, khách nào tình cờ rơi vào từng nhóm vẫn tạo ra biến động ngẫu nhiên. Cơ cấu khách hàng hoặc nhu cầu ở giai đoạn triển khai sau này cũng có thể khác thời gian thử nghiệm. Một phép tính đúng cần đi cùng việc xem xét những yếu tố này.
Bước 2: Đặt giả thuyết và đọc dữ liệu
Gọi pA và pB là tỷ lệ mua thật sự khi dùng từng phiên bản:
- H0: pB = pA.
- H1: pB ≠ pA.
| Chỉ số | Phiên bản A | Phiên bản B |
|---|---|---|
| Số khách | 1.000 | 1.000 |
| Số khách mua hàng | 100 | 130 |
| Số khách không mua | 900 | 870 |
| Tỷ lệ mua trong mẫu | 10% | 13% |
Chênh lệch tuyệt đối là 13% − 10% = 3 điểm phần trăm. Mức tăng tương đối là (13% − 10%) / 10% = 30%.
Bước 3: Tính thống kê z và p-value
Dưới H0, hai nhóm có chung một tỷ lệ mua. Ta ước lượng tỷ lệ chung bằng cách gộp số người mua và tổng số người:
Tỷ lệ gộp = (100 + 130) / (1.000 + 1.000) = 0,115.
Sai số chuẩn của chênh lệch theo H0 được tính như sau:
SE0 = √{0,115 × 0,885 × (1 / 1.000 + 1 / 1.000)} ≈ 0,014267.
Do đó:
z = (0,13 − 0,10) / 0,014267 ≈ 2,1027.
Chênh lệch quan sát nằm cách mốc không chênh lệch khoảng 2,10 sai số chuẩn. Với kiểm định z hai phía, p-value xấp xỉ 0,035488. Phương pháp so sánh hai tỷ lệ được trình bày trong hướng dẫn của NIST.
Vì 0,035488 < 0,05, ta bác bỏ H0 theo thiết kế này. Dữ liệu cung cấp bằng chứng về chênh lệch giữa hai tỷ lệ; mức ước lượng của B cao hơn A.
Bước 4: Xem mức cải thiện và độ không chắc chắn
Effect size, độ lớn hiệu ứng, trả lời câu hỏi “khác bao nhiêu?”. Trong ví dụ này, một cách thể hiện effect size là chênh lệch 3 điểm phần trăm. Confidence interval, khoảng tin cậy, viết tắt CI, giúp thể hiện độ không chắc chắn của ước lượng đó.
Với xấp xỉ chuẩn dùng sai số chuẩn ước lượng riêng từ hai nhóm, khoảng tin cậy 95% cho chênh lệch pB − pA được tính bằng:
0,03 ± 1,96 × √{0,10 × 0,90 / 1.000 + 0,13 × 0,87 / 1.000}.
Kết quả xấp xỉ từ 0,21 đến 5,79 điểm phần trăm. Đây là khoảng xấp xỉ Wald cho hai tỷ lệ với mẫu lớn. Sai số chuẩn trong khoảng này dùng tỷ lệ riêng của từng nhóm; phép kiểm định ở bước trước dùng tỷ lệ gộp theo H0.
Cách hiểu mức tin cậy 95% là: nếu lấy mẫu và lập khoảng theo cùng một phương pháp rất nhiều lần, khoảng 95% các khoảng sẽ chứa chênh lệch thật, khi các giả định phù hợp. Không diễn giải thành “95% khách hàng nằm trong khoảng này”. Xem giải thích về khoảng tin cậy của NIST.
Giả sử trước thử nghiệm, doanh nghiệp xác định mức tăng tối thiểu đáng triển khai là 2 điểm phần trăm. Ước lượng 3 điểm phần trăm vượt mốc đó, nhưng khoảng tin cậy vẫn bao gồm những mức tăng nhỏ hơn 2. Vì vậy, chưa thể khẳng định mức cải thiện thật đạt ít nhất 2 điểm phần trăm chỉ bằng kết quả này.
Quyết định triển khai còn phụ thuộc vào chi phí thay đổi, khả năng hoàn tác và những chỉ số khác như tỷ lệ hoàn hàng. Nếu B làm tăng lượt mua nhưng cũng khiến hoàn hàng tăng mạnh, chỉ nhìn p-value của tỷ lệ mua sẽ bỏ sót một phần quan trọng của kết quả.
Bước 5: Tự chạy phép tính bằng Python
from math import sqrt
from scipy.stats import norm

n_a, buyers_a = 1000, 100
n_b, buyers_b = 1000, 130

rate_a = buyers_a / n_a
rate_b = buyers_b / n_b
difference = rate_b - rate_a

pooled_rate = (buyers_a + buyers_b) / (n_a + n_b)
se_null = sqrt(
    pooled_rate * (1 - pooled_rate) * (1 / n_a + 1 / n_b)
)
z_stat = difference / se_null
p_value = 2 * norm.sf(abs(z_stat))

se_difference = sqrt(
    rate_a * (1 - rate_a) / n_a
    + rate_b * (1 - rate_b) / n_b
)
ci_low = difference - 1.96 * se_difference
ci_high = difference + 1.96 * se_difference

print(f"z = {z_stat:.4f}")
print(f"p-value = {p_value:.6f}")
print(f"Chenh lech = {difference * 100:.2f} diem phan tram")
print(
    f"CI 95% = {ci_low * 100:.2f} den "
    f"{ci_high * 100:.2f} diem phan tram"
)
z = 2.1027
p-value = 0.035488
Chenh lech = 3.00 diem phan tram
CI 95% = 0.21 den 5.79 diem phan tram
norm.sf(z) tính xác suất ở bên phải z của phân phối chuẩn chuẩn hóa. Do đây là kiểm định hai phía với phân phối đối xứng, ta dùng 2 * norm.sf(abs(z_stat)). Xem tài liệu về norm của SciPy.
Phép tính này giả định hai nhóm độc lập và cỡ mẫu đủ cho xấp xỉ chuẩn. Một người xuất hiện nhiều lần, phân nhóm theo hộ gia đình, hoặc rất ít người mua có thể đòi hỏi cách phân tích khác.
Cùng tăng từ 10% lên 13%, vì sao cỡ mẫu làm thay đổi kết luận?
| Số khách mỗi nhóm | A | B | P-value xấp xỉ | Kết quả ở mức 5% |
|---|---|---|---|---|
| 100 | 10 / 100 = 10% | 13 / 100 = 13% | 0,506086 | Chưa bác bỏ H0. |
| 1.000 | 100 / 1.000 = 10% | 130 / 1.000 = 13% | 0,035488 | Bác bỏ H0. |
Với 100 người mỗi nhóm, chênh lệch số người mua chỉ là 3 người. Với 1.000 người mỗi nhóm, chênh lệch là 30 người và tỷ lệ được ước lượng ít nhiễu hơn. Độ lớn hiệu ứng quan sát vẫn là 3 điểm phần trăm, nhưng độ không chắc chắn khác nhau.
Bảng này so sánh hai bộ số liệu được đặt ra với cùng tỷ lệ. Trong một thử nghiệm đang chạy, tăng cỡ mẫu không bảo đảm p-value sẽ giảm, vì tỷ lệ quan sát cũng có thể thay đổi khi có dữ liệu mới.
8. Ví dụ 3: Tỷ lệ trong một khảo sát có vượt 52%?
Giả sử chúng ta khảo sát phụ huynh có con từ 13 đến 18 tuổi về nhận định: “Thiết bị công nghệ và mạng xã hội khiến con tôi thiếu ngủ”. Mục tiêu là đánh giá xem tỷ lệ phụ huynh đồng ý có vượt một mốc tham chiếu cố định là 52% hay không.
Trong ví dụ minh họa, có 1.018 người trả lời hợp lệ và 570 người đồng ý. Giả sử cách lấy mẫu phù hợp với tổng thể cần nghiên cứu, các câu trả lời độc lập và không sử dụng trọng số khảo sát.
Bước 1: Xác định đại lượng và giả thuyết
Gọi p là tỷ lệ phụ huynh trong tổng thể đồng ý với nhận định trên:
- H0: p ≤ 0,52.
- H1: p > 0,52.
Đây là kiểm định một phía, dùng mốc biên p0 = 0,52 để tính xác suất. Chọn trước α = 0,05.
Tỷ lệ mẫu = 570 / 1.018 ≈ 0,559921, tương đương 55,99%.
Phải dùng số người thực tế là một số nguyên. Nếu báo cáo chỉ ghi “56% trong 1.018 người”, không thể suy ra chính xác số người đồng ý, vì tỷ lệ có thể đã được làm tròn. Phép nhân 0,56 × 1.018 cho 570,08 người không phải số đếm hợp lệ. Con số 570 ở đây là dữ liệu giả định đã nêu rõ.
Bước 2: Dùng kiểm định nhị thức chính xác
Nếu tỷ lệ thật là 52%, xác suất có ít nhất 570 người đồng ý trong 1.018 người là bao nhiêu? Đây chính là p-value một phía trong mô hình nhị thức của ví dụ.
from scipy.stats import binomtest

n = 1018
count_agree = 570
reference_rate = 0.52
alpha = 0.05

result = binomtest(
    k=count_agree,
    n=n,
    p=reference_rate,
    alternative="greater"
)

print(f"Ty le mau = {count_agree / n:.4%}")
print(f"p-value = {result.pvalue:.6f}")

if result.pvalue <= alpha:
    print("Bac bo H0 o muc y nghia 5%.")
else:
    print("Chua du bang chung de bac bo H0.")
Ty le mau = 55.9921%
p-value = 0.005843
Bac bo H0 o muc y nghia 5%.
Vì 0,005843 < 0,05, dữ liệu cung cấp bằng chứng rằng tỷ lệ phụ huynh đồng ý vượt 52%, trong phạm vi các giả định đã nêu.
Bước 3: Đối chiếu với kiểm định z
Với mẫu đủ lớn, ta cũng có thể dùng xấp xỉ chuẩn cho tỷ lệ. Công thức dùng phương sai theo H0 là:
z = (570 / 1.018 − 0,52) / √{0,52 × 0,48 / 1.018} ≈ 2,5495.
from math import sqrt
from scipy.stats import norm

n = 1018
count_agree = 570
p0 = 0.52
sample_rate = count_agree / n

se_null = sqrt(p0 * (1 - p0) / n)
z_stat = (sample_rate - p0) / se_null
p_value = norm.sf(z_stat)

print(f"z = {z_stat:.4f}")
print(f"p-value xap xi = {p_value:.6f}")
z = 2.5495
p-value xap xi = 0.005394
Kết quả 0,005394 khác nhẹ 0,005843 vì một cách dùng xấp xỉ chuẩn không hiệu chỉnh liên tục, còn cách kia tính trực tiếp theo phân phối nhị thức. Cả hai đều dẫn đến bác bỏ H0 ở mức 5% trong ví dụ này. Công thức xấp xỉ được trình bày trong tài liệu kiểm định một tỷ lệ của NIST.
Nếu dùng proportions_ztest của statsmodels, tham số prop_var=p0 giúp phương sai được tính tại mốc H0, khớp công thức trên. Mặc định của hàm dùng tỷ lệ mẫu cho phương sai, nên có thể cho kết quả khác. Xem tài liệu chính thức của statsmodels.
Kết luận đến đâu thì dừng ở đó
Khảo sát này đo niềm tin của phụ huynh. Nó không trực tiếp đo thời lượng ngủ của trẻ và không chứng minh thiết bị công nghệ gây thiếu ngủ. Để trả lời câu hỏi nguyên nhân, cần một thiết kế nghiên cứu khác và dữ liệu phù hợp.
Ngoài ra, nếu mốc 52% thực ra được ước lượng từ một khảo sát trước, thay vì là mốc cố định, thì bản thân mốc này cũng có sai số lấy mẫu. Muốn so sánh hai giai đoạn cần thêm cỡ mẫu, số người đồng ý và thông tin về thiết kế của khảo sát trước. Không nên bỏ qua sự không chắc chắn của khảo sát cũ.
Từ “chính xác” trong kiểm định nhị thức chỉ nói rằng phép tính không dựa vào xấp xỉ chuẩn. Nó không biến một mẫu khảo sát thiên lệch thành mẫu đại diện.
9. Ví dụ 4: Máy có rót trung bình đúng 500 ml?
Ba ví dụ trước đều xét tỷ lệ. Kiểm định giả thuyết cũng dùng được với đại lượng liên tục như thể tích, thời gian hoặc khối lượng.
Giả sử một máy được đặt mục tiêu rót trung bình 500 ml mỗi chai. Lấy ngẫu nhiên 25 chai trong giai đoạn máy vận hành ổn định, ta được thể tích trung bình 496 ml và độ lệch chuẩn mẫu 8 ml. Giả sử các quan sát độc lập, phân phối thể tích gần chuẩn và không có ngoại lệ nghiêm trọng.
- H0: μ = 500 ml.
- H1: μ ≠ 500 ml.
Ký hiệu μ, đọc là mu, chỉ trung bình thật sự của quá trình. Câu hỏi ở đây xét cả việc rót thiếu lẫn rót thừa, nên dùng kiểm định hai phía với α = 0,05.
Tính từng bước
- Chênh lệch quan sát: 496 − 500 = −4 ml.
- Sai số chuẩn của trung bình: SE = 8 / √25 = 1,6 ml.
- Thống kê kiểm định: t = −4 / 1,6 = −2,5.
- Bậc tự do: df = n − 1 = 24.
- P-value hai phía theo phân phối t với 24 bậc tự do: khoảng 0,019654.
Ta dùng phân phối t vì độ lệch chuẩn của tổng thể chưa biết và được ước lượng từ mẫu. Đây là one-sample t-test, kiểm định t một mẫu. Điều kiện phân phối đặc biệt cần được xem xét khi mẫu nhỏ. Xem hướng dẫn kiểm định trung bình của NIST.
Do p-value nhỏ hơn 0,05, ta bác bỏ H0. Với các giả định của ví dụ, dữ liệu cho thấy thể tích trung bình khác 500 ml; ước lượng trung bình đang thấp hơn mục tiêu 4 ml.
Tính từ số liệu tóm tắt bằng Python
from math import sqrt
from scipy.stats import t

n = 25
sample_mean = 496
sample_sd = 8
target_mean = 500

se = sample_sd / sqrt(n)
t_stat = (sample_mean - target_mean) / se
df = n - 1
p_value = 2 * t.sf(abs(t_stat), df=df)

print(f"SE = {se:.2f} ml")
print(f"t = {t_stat:.4f}")
print(f"df = {df}")
print(f"p-value = {p_value:.6f}")
SE = 1.60 ml
t = -2.5000
df = 24
p-value = 0.019654
Nếu có số đo của từng chai, có thể dùng trực tiếp hàm ttest_1samp của SciPy để tính kiểm định từ dữ liệu gốc.
Kết luận này nói về trung bình của quá trình. Nó không nói rằng mọi chai đều thiếu đúng 4 ml. Muốn đánh giá độ đồng đều giữa các chai, cần xem thêm độ phân tán và các số đo riêng lẻ.
10. Quy trình kiểm định từ câu hỏi đến kết luận
Để áp dụng vào bài toán của mình, bạn có thể đi theo sáu bước sau:
- Viết một câu hỏi có thể đo được. Thay vì hỏi “giao diện mới có tốt hơn không?”, hãy hỏi “giao diện mới có làm thay đổi tỷ lệ khách mua ít nhất một lần trong bảy ngày không?”. Cần xác định cả đối tượng, chỉ số và thời gian đo.
- Chọn giả thuyết và quy tắc trước khi xem kết quả. Viết H0, H1, chọn một phía hoặc hai phía, chọn α và xác định mức khác biệt nhỏ nhất có ý nghĩa thực tế.
- Thiết kế việc thu thập dữ liệu. Xác định đơn vị quan sát, cách lấy mẫu hoặc phân nhóm, cỡ mẫu và quy tắc kết thúc. Muốn tính cỡ mẫu cần quan tâm cả mức khác biệt cần phát hiện và power, chứ không chỉ chọn một số người cho tiện. Xem hướng dẫn xác định cỡ mẫu cho tỷ lệ của NIST.
- Kiểm tra dữ liệu và chọn phép kiểm định phù hợp. Dữ liệu là tỷ lệ hay số đo liên tục? Các nhóm có độc lập không? Có quan sát trùng, dữ liệu thiếu hoặc điều kiện nào làm mô hình không phù hợp không?
- Tính kết quả và độ không chắc chắn. Báo cáo số quan sát, ước lượng, thống kê kiểm định, p-value và khoảng tin cậy phù hợp. Nêu rõ phương pháp và những giả định quan trọng.
- Viết kết luận đúng phạm vi. Tách việc bác bỏ H0 khỏi quyết định có đáng triển khai hay không. Xem cả mức tác động, chi phí, chất lượng dữ liệu và khả năng bối cảnh thay đổi.
Nên bắt đầu tìm hiểu phép kiểm định nào?
| Bài toán | Phương pháp có thể phù hợp | Điều cần kiểm tra |
|---|---|---|
| Một tỷ lệ so với một mốc cố định. | Kiểm định nhị thức chính xác; hoặc z một tỷ lệ khi xấp xỉ phù hợp. | Số đếm, tính độc lập và mô hình nhị thức. |
| Hai tỷ lệ của hai nhóm độc lập. | Kiểm định z hai tỷ lệ với mẫu đủ lớn. | Thiết kế nhóm và số quan sát ở cả hai kết quả, chẳng hạn mua và không mua. |
| Một trung bình so với một mốc. | Kiểm định t một mẫu khi chưa biết độ lệch chuẩn tổng thể. | Tính độc lập, ngoại lệ và mức phù hợp của giả định phân phối. |
| Hai trung bình của hai nhóm độc lập. | Kiểm định t Welch. | Nhóm phải độc lập; cần xem phân phối và các ngoại lệ. |
Welch t-test không yêu cầu hai nhóm có phương sai bằng nhau. Trong SciPy, tùy chọn equal_var=False của ttest_ind chọn kiểm định này. Nếu đo cùng một người trước và sau một thay đổi, dữ liệu có ghép cặp; không nên áp dụng máy móc phép kiểm định dành cho hai nhóm độc lập.
Bảng trên là điểm bắt đầu để chọn phương pháp, không thay thế việc kiểm tra thiết kế nghiên cứu. Không có một hàm Python duy nhất phù hợp với mọi câu hỏi.
Mẫu câu báo cáo một kết quả
Trong thử nghiệm với 1.000 khách mỗi nhóm, tỷ lệ mua của A là 10% và của B là 13%. Chênh lệch ước lượng là 3 điểm phần trăm, với khoảng tin cậy 95% xấp xỉ từ 0,21 đến 5,79 điểm phần trăm. Kiểm định z hai phía cho p-value = 0,035488; tại mức ý nghĩa 5% đã chọn trước, chúng tôi bác bỏ giả thuyết hai tỷ lệ bằng nhau. Kết quả cung cấp bằng chứng về mức tăng tỷ lệ mua trong điều kiện thử nghiệm, nhưng chưa xác lập rằng mức tăng thật đạt ít nhất 2 điểm phần trăm.
Cách viết này cho người đọc biết đã đo gì, chênh lệch bao nhiêu và còn chưa chắc điều gì. Một câu chỉ ghi “p < 0,05 nên B tốt hơn” thiếu những thông tin cần thiết đó.
11. Những sai lầm dễ làm kết quả mất giá trị
Chỉ nhìn vào việc p-value có dưới 0,05 hay không
Hai kết quả p-value = 0,049 và p-value = 0,051 nằm ở hai phía của ngưỡng 0,05, nhưng không đại diện cho hai mức bằng chứng hoàn toàn đối lập. Khi áp dụng một quy tắc đã định trước, quyết định bác bỏ có thể khác; khi giải thích kết quả, vẫn cần xem dữ liệu và độ không chắc chắn.
ASA khuyến cáo không đưa ra kết luận khoa học hoặc quyết định kinh doanh chỉ dựa vào việc p-value có vượt một ngưỡng hay không; p-value cũng không đo độ lớn hoặc tầm quan trọng của hiệu ứng. Xem các nguyên tắc diễn giải của ASA.
Thử nhiều cách rồi chỉ báo cáo cách có kết quả đẹp
Giả sử bạn thực hiện 20 kiểm định độc lập, tất cả H0 đều đúng và mỗi kiểm định có xác suất báo động nhầm đúng bằng 5%. Xác suất có ít nhất một báo động nhầm là:
1 − (1 − 0,05)20 ≈ 0,6415, tức khoảng 64,15%.
Con số này đến từ việc tính xác suất cả 20 kiểm định đều không báo động nhầm, rồi lấy 1 trừ đi xác suất đó. Nó phụ thuộc vào các giả định độc lập và mức sai lầm 5% đã nêu.
Nếu bạn thử hàng chục nhóm tuổi, khung giờ và chỉ số, rồi chỉ công bố một kết quả có p-value nhỏ, người đọc sẽ không thấy toàn bộ quá trình tìm kiếm. Cần xác định trước phân tích chính, báo cáo những gì đã thử và dùng cách xử lý phù hợp cho việc kiểm định nhiều lần.
Liên tục xem kết quả rồi dừng ngay khi đạt ngưỡng
Một kiểm định được thiết kế để phân tích sau một cỡ mẫu cố định không tự động giữ nguyên mức sai lầm nếu bạn xem kết quả mỗi ngày và dừng khi p-value vừa xuống dưới 0,05.
Trong ví dụ tung đồng xu, việc định trước 10 lần tung là một phần của thiết kế. Nếu sau 10 lần chưa đạt ngưỡng, bạn tiếp tục tung và kiểm tra sau từng lần cho đến khi đạt, bạn đã dùng một quy tắc khác. Muốn cho phép kết thúc sớm dựa trên dữ liệu, cần thiết kế phương pháp phân tích tuần tự phù hợp từ trước.
Dùng mẫu lớn để che một cách lấy mẫu sai
Giả sử bạn khảo sát quan điểm của toàn bộ phụ huynh, nhưng chỉ đăng bảng hỏi trong một nhóm chuyên phản đối việc trẻ dùng điện thoại. Thu được rất nhiều câu trả lời vẫn không giải quyết được việc nhóm người tham gia có thể khác tổng thể bạn muốn tìm hiểu.
Mẫu lớn có thể làm sai số ngẫu nhiên nhỏ đi, trong khi sai lệch do tuyển người trả lời vẫn còn. Trong tình huống đó, p-value nhỏ có thể đi cùng một kết luận không áp dụng được cho tổng thể mục tiêu.
Nhầm ý nghĩa thống kê với tác động thực tế
Giả sử một thay đổi giao diện làm tỷ lệ mua tăng từ 10% lên 10,02%. Mức tăng là 0,02 điểm phần trăm, tương ứng khoảng 2 lượt mua thêm trên 10.000 khách nếu hiệu ứng giữ nguyên.
Với đủ dữ liệu và mô hình phù hợp, một mức tăng nhỏ như vậy vẫn có thể được phát hiện bằng thống kê. Nhưng việc có đáng thực hiện hay không phụ thuộc vào lợi ích của số lượt mua tăng thêm và chi phí thay đổi. Ngược lại, một mức cải thiện lớn có thể chưa đạt ý nghĩa thống kê khi mẫu quá ít.
Nhầm mối liên hệ với quan hệ nhân quả
Nếu người dùng bản B mua nhiều hơn nhưng phần lớn họ là khách cũ, còn nhóm A chủ yếu là khách mới, chênh lệch có thể đến từ cơ cấu khách hàng. Chỉ dùng kiểm định để so hai tỷ lệ không tự loại bỏ được cách giải thích này.
Phân nhóm ngẫu nhiên và vận hành thử nghiệm đúng cách giúp việc diễn giải tác động của giao diện có cơ sở hơn. Dù vậy, vẫn cần kiểm tra việc phân nhóm có được giữ đúng, dữ liệu có bị thiếu khác nhau giữa hai nhóm và cách đo kết quả có nhất quán hay không.
12. Các câu hỏi thường gặp
P-value lớn có chứng minh H0 đúng không?
Không. Nó cho biết kiểm định chưa tìm được đủ bằng chứng để bác bỏ H0 theo ngưỡng đã chọn. Dữ liệu ít hoặc phép đo nhiều nhiễu cũng có thể khiến ta bỏ sót một khác biệt thật.
Nếu mục tiêu là chứng minh hai phương án đủ gần nhau để sử dụng thay thế, cần định nghĩa trước “đủ gần” là bao nhiêu và thiết kế kiểm định tương đương phù hợp. Không thể lấy p-value lớn trong một kiểm định khác biệt thông thường làm bằng chứng hai phương án tương đương.
P-value nhỏ hơn 0,05 có nghĩa kết quả chắc chắn không do ngẫu nhiên không?
Không. Một kết quả hiếm theo H0 vẫn có thể xảy ra khi H0 đúng. Chính vì vậy mới có sai lầm loại I. P-value nhỏ cũng có thể xuất hiện khi mô hình hoặc cách phân tích không phù hợp.
Mọi kiểm định có cần dữ liệu tuân theo phân phối chuẩn không?
Không. Kiểm định nhị thức chính xác trong ví dụ đồng xu dùng mô hình nhị thức. Kiểm định z cho tỷ lệ dựa vào xấp xỉ chuẩn của thống kê mẫu, chứ không đòi hỏi từng quan sát mua hoặc không mua phải có phân phối chuẩn. Mỗi phương pháp có điều kiện riêng.
Có bao nhiêu người tham gia thì đủ?
Không có một con số đúng cho mọi trường hợp. Cỡ mẫu cần thiết phụ thuộc vào mức khác biệt bạn muốn phát hiện, độ biến động của dữ liệu, mức ý nghĩa, power mong muốn và thiết kế lấy mẫu. Muốn phát hiện một mức tăng rất nhỏ thường cần nhiều dữ liệu hơn so với phát hiện một mức tăng lớn trong cùng điều kiện.
Nếu phần mềm in p-value bằng 0 thì hiểu thế nào?
Cần kiểm tra độ chính xác và cách hiển thị của phần mềm. Một giá trị rất nhỏ có thể bị làm tròn thành 0 hoặc nằm ngoài khả năng biểu diễn số thông thường. Không nên từ con số hiển thị đó suy ra rằng H0 có xác suất đúng bằng 0.
Khi đọc một kết quả kiểm định, hãy tìm đủ bốn điều: câu hỏi đang được kiểm tra, cách dữ liệu được thu thập, mức khác biệt quan sát và độ không chắc chắn của nó. Khi bốn điều này rõ ràng, p-value mới được đặt vào đúng bối cảnh để hỗ trợ kết luận.
Hi vọng thông qua bài viết này, các bạn đã có hình dung ban đầu về kiểm chứng giả thuyết. Nếu bạn thích bài viết này, đừng ngại chia sẻ với những người quan tâm. Hãy thường xuyên truy cập website để có những kiến thức cập nhật về lĩnh vực.