Không cần trung tâm dữ liệu để hiểu một mô hình ngôn ngữ hiện đại hoạt động như thế nào. Dự án mã nguồn mở này đưa những ý tưởng quan trọng của GLM-5.3-Flash vào một mô hình nhỏ, đủ để học từng thành phần và thử nghiệm trên máy cá nhân.
Huấn luyện một Large Language Model
Language Model
Mô hình ngôn ngữ là phân phối xác suất trên các chuỗi từ hoặc ký tự. Mô hình này có thể giúp dự đoán từ hoặc ký tự tiếp theo trong một chuỗi các từ hoặc ký tự. Mô hình ngôn ngữ sử dụng mạng nơ ron có kết quả nổi bật hơn so với các phương pháp khác trong các bài toán NLP khác nhau như sinh văn bản, dịch máy, chú thích hình ảnh, OCR...
(LLM
LLM
LLM (Large Language Model), tạm dịch là Mô Hình Ngôn Ngữ Lớn, là một loại mô hình trí tuệ nhân tạo (AI) được thiết kế để hiểu và tạo ra văn bản ngôn ngữ tự nhiên. Những mô hình này thường dựa trên kiến trúc mạng neuron sâu, như Transformer, và được đào tạo trên một lượng dữ liệu văn bản khổng lồ. LLM có khả năng thực hiện nhiều nhiệm vụ liên quan đến ngôn ngữ như dịch thuật, tóm tắt, trả lời câu hỏi, và thậm chí là tạo ra văn bản hoàn chỉnh từ đầu. Những mô hình này đã và đang được sử dụng rộng rãi trong nhiều ứng dụng công nghệ và dịch vụ trực tuyến.
) quy mô hàng trăm tỷ tham số thường đòi hỏi phần cứng và nguồn dữ liệu rất lớn. Nhưng nếu mục tiêu là hiểu cơ chế hoạt động của LLM
LLM
LLM (Large Language Model), tạm dịch là Mô Hình Ngôn Ngữ Lớn, là một loại mô hình trí tuệ nhân tạo (AI) được thiết kế để hiểu và tạo ra văn bản ngôn ngữ tự nhiên. Những mô hình này thường dựa trên kiến trúc mạng neuron sâu, như Transformer, và được đào tạo trên một lượng dữ liệu văn bản khổng lồ. LLM có khả năng thực hiện nhiều nhiệm vụ liên quan đến ngôn ngữ như dịch thuật, tóm tắt, trả lời câu hỏi, và thậm chí là tạo ra văn bản hoàn chỉnh từ đầu. Những mô hình này đã và đang được sử dụng rộng rãi trong nhiều ứng dụng công nghệ và dịch vụ trực tuyến.
, chúng ta không nhất thiết phải bắt đầu ở quy mô đó.
Trong khóa học được freeCodeCamp giới thiệu ngày 14/11/2026, tác giả Vuk Rosić xây dựng từ đầu một mô hình Python khoảng 25,7 triệu tham số, lấy cảm hứng từ GLM-5.3-Flash. Dự án bao gồm huấn luyện trước (pre-training), xử lý hình ảnh và tối ưu hóa bằng reinforcement learning (học tăng cường). Mã nguồn, slide và báo cáo thí nghiệm được công khai trên GitHub.
Cần phân biệt: Đây là một bản mô phỏng phục vụ giáo dục, không phải phiên bản GLM-5.3-Flash chính thức được huấn luyện lại từ đầu. Một số thành phần giữ nguyên ý tưởng kiến trúc, nhưng cách cài đặt đã được đơn giản hóa đáng kể.
1. GLM-5.3-Flash có gì đáng học?
Thay vì chỉ dùng một cơ chế attention
Attention
Có thể dịch nôm là Cơ chế chú ý. Đây là kỹ thuật dựa trên khái niệm về sự chú ý trong nhận thức của con người, kỹ thuật này giúp mô hình tập trung vào những yếu tố đặc biệt nhất định trong dữ liệu.
và một mạng feed-forward như Transformer
Transformer
Transformer là mô hình học sâu được giới thiệu vào năm 2017, được sử dụng chủ yếu trong lĩnh vực xử lý ngôn ngữ tự nhiên (NLP).
cơ bản, dòng kiến trúc này kết hợp nhiều kỹ thuật để cân bằng khả năng xử lý ngữ cảnh, dung lượng tham số và chi phí tính toán. Bốn chủ đề nổi bật là Hybrid Attention
Attention
Có thể dịch nôm là Cơ chế chú ý. Đây là kỹ thuật dựa trên khái niệm về sự chú ý trong nhận thức của con người, kỹ thuật này giúp mô hình tập trung vào những yếu tố đặc biệt nhất định trong dữ liệu.
, Mixture of Experts, Hyperconnections và Multimodality.
Để tránh nhầm lẫn giữa mô hình được phát hành và dự án thực hành, hãy nhìn vào bảng sau:
Thành phần
GLM-5.3-Flash gốc
Dự án thực hành
Tham số tổng
Khoảng 320 tỷ
25.730.592
Tham số hoạt động/token
Token
NLP - Một chuỗi gồm một hoặc nhiều ký tự được ánh xạ làm đầu vào cho các mô hình trong NLP. Trong word embedding, token là chuỗi các ký tự liền kề giữa hai khoảng trắng hoặc giữa dấu cách và dấu chấm.
Blockchain - Token là một loại tài sản kỹ thuật số được phát hành và hoạt động trên một nền tảng Blockchain của các dự án có sẵn mà không sở hữu Blockchain riêng.
Khoảng 18 tỷ
Khoảng 9,8 triệu (ước tính của dự án)
Số lớp ngôn ngữ
45
12
Attention
Attention
Có thể dịch nôm là Cơ chế chú ý. Đây là kỹ thuật dựa trên khái niệm về sự chú ý trong nhận thức của con người, kỹ thuật này giúp mô hình tập trung vào những yếu tố đặc biệt nhất định trong dữ liệu.
Linear + Sparse, cơ chế đặc thù
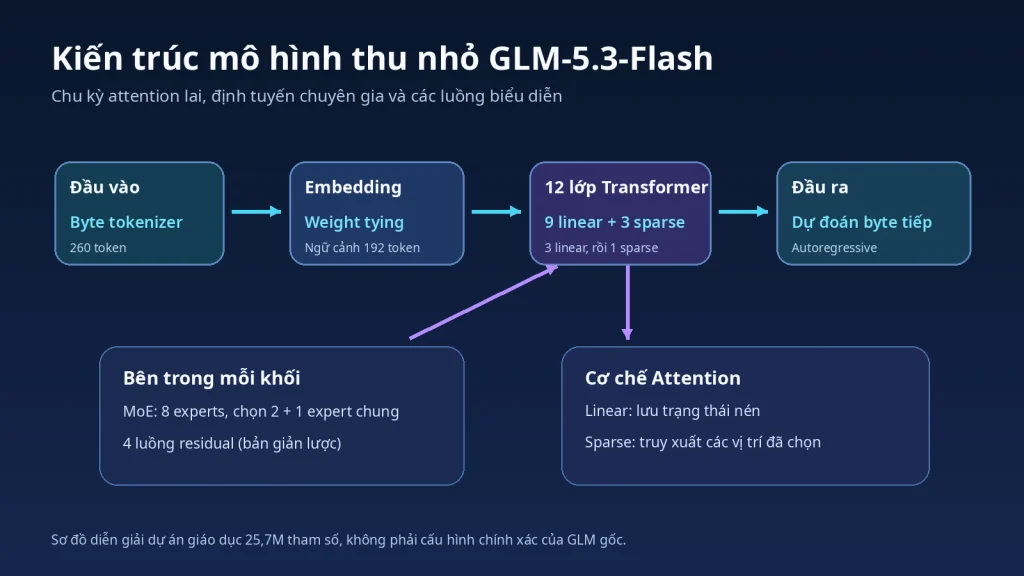
9 lớp linear + 3 lớp sparse giản lược
Mixture of Experts
288 chuyên gia, chọn 8
8 chuyên gia, chọn 2; thêm 1 chuyên gia chung
Tokenizer
Byte-level BPE, 154.880 token
Token
NLP - Một chuỗi gồm một hoặc nhiều ký tự được ánh xạ làm đầu vào cho các mô hình trong NLP. Trong word embedding, token là chuỗi các ký tự liền kề giữa hai khoảng trắng hoặc giữa dấu cách và dấu chấm.
Blockchain - Token là một loại tài sản kỹ thuật số được phát hành và hoạt động trên một nền tảng Blockchain của các dự án có sẵn mà không sở hữu Blockchain riêng.
Byte-level, 260 token
Token
NLP - Một chuỗi gồm một hoặc nhiều ký tự được ánh xạ làm đầu vào cho các mô hình trong NLP. Trong word embedding, token là chuỗi các ký tự liền kề giữa hai khoảng trắng hoặc giữa dấu cách và dấu chấm.
Blockchain - Token là một loại tài sản kỹ thuật số được phát hành và hoạt động trên một nền tảng Blockchain của các dự án có sẵn mà không sở hữu Blockchain riêng.
Context window
Tối đa khoảng 1 triệu token
Token
NLP - Một chuỗi gồm một hoặc nhiều ký tự được ánh xạ làm đầu vào cho các mô hình trong NLP. Trong word embedding, token là chuỗi các ký tự liền kề giữa hai khoảng trắng hoặc giữa dấu cách và dấu chấm.
Blockchain - Token là một loại tài sản kỹ thuật số được phát hành và hoạt động trên một nền tảng Blockchain của các dự án có sẵn mà không sở hữu Blockchain riêng.
192 token
Token
NLP - Một chuỗi gồm một hoặc nhiều ký tự được ánh xạ làm đầu vào cho các mô hình trong NLP. Trong word embedding, token là chuỗi các ký tự liền kề giữa hai khoảng trắng hoặc giữa dấu cách và dấu chấm.
Blockchain - Token là một loại tài sản kỹ thuật số được phát hành và hoạt động trên một nền tảng Blockchain của các dự án có sẵn mà không sở hữu Blockchain riêng.
Bài học quan trọng: Số tham số lớn không phải điều kiện bắt buộc để nghiên cứu một ý tưởng kiến trúc. Mô hình nhỏ giúp quan sát rõ từng phép biến đổi, từng hàm loss
Loss
Máy tính học thông qua hàm loss. Đây là một phương pháp đánh giá xem mô hình biểu diễn dữ liệu đã cho tốt đến đâu. Mô hình biểu diễn càng tốt thì giá trị loss càng nhỏ.
và từng thay đổi sau huấn luyện, dù khả năng thực tế không thể so sánh với bản gốc.
2. Kiến trúc bên trong: Tokenizer, Attention và MoE
Tokenizer: Đưa văn bản về đơn vị nhỏ nhất
Tokenization là bước chuyển văn bản thành các chỉ số mà mô hình có thể xử lý. Trong dự án, tác giả chọn byte-level tokenizer gồm 256 giá trị byte và 4 token
Token
NLP - Một chuỗi gồm một hoặc nhiều ký tự được ánh xạ làm đầu vào cho các mô hình trong NLP. Trong word embedding, token là chuỗi các ký tự liền kề giữa hai khoảng trắng hoặc giữa dấu cách và dấu chấm.
Blockchain - Token là một loại tài sản kỹ thuật số được phát hành và hoạt động trên một nền tảng Blockchain của các dự án có sẵn mà không sở hữu Blockchain riêng.
điều khiển, tổng cộng 260 token
Token
NLP - Một chuỗi gồm một hoặc nhiều ký tự được ánh xạ làm đầu vào cho các mô hình trong NLP. Trong word embedding, token là chuỗi các ký tự liền kề giữa hai khoảng trắng hoặc giữa dấu cách và dấu chấm.
Blockchain - Token là một loại tài sản kỹ thuật số được phát hành và hoạt động trên một nền tảng Blockchain của các dự án có sẵn mà không sở hữu Blockchain riêng.
. Cách làm này đơn giản, không cần huấn luyện bảng từ vựng và biểu diễn được mọi chuỗi UTF-8.
Đổi lại, một chữ tiếng Việt có dấu có thể chiếm nhiều byte. Vì thế, 192 token
Token
NLP - Một chuỗi gồm một hoặc nhiều ký tự được ánh xạ làm đầu vào cho các mô hình trong NLP. Trong word embedding, token là chuỗi các ký tự liền kề giữa hai khoảng trắng hoặc giữa dấu cách và dấu chấm.
Blockchain - Token là một loại tài sản kỹ thuật số được phát hành và hoạt động trên một nền tảng Blockchain của các dự án có sẵn mà không sở hữu Blockchain riêng.
không đồng nghĩa với 192 từ hoặc 192 ký tự. Với mô hình nhỏ, lựa chọn này thuận tiện cho mục đích học tập nhưng làm chuỗi đầu vào dài hơn so với tokenizer BPE.
Dự án còn dùng weight tying, tức là chia sẻ ma trận trọng số giữa lớp embedding
Embedding
Phương pháp chuyển đầu vào thành một biểu diễn khác dễ dàng xử lý hơn đối với máy tính (thường là các véc tơ).
và lớp dự đoán đầu ra. Đây là một cách giảm số tham số cần học.
Hybrid Attention: Kết hợp hai phương pháp xử lý ngữ cảnh
Linear Attention
Attention
Có thể dịch nôm là Cơ chế chú ý. Đây là kỹ thuật dựa trên khái niệm về sự chú ý trong nhận thức của con người, kỹ thuật này giúp mô hình tập trung vào những yếu tố đặc biệt nhất định trong dữ liệu.
sử dụng biểu diễn trạng thái nén để tránh phải tạo đầy đủ ma trận attention
Attention
Có thể dịch nôm là Cơ chế chú ý. Đây là kỹ thuật dựa trên khái niệm về sự chú ý trong nhận thức của con người, kỹ thuật này giúp mô hình tập trung vào những yếu tố đặc biệt nhất định trong dữ liệu.
giữa mọi cặp token
Token
NLP - Một chuỗi gồm một hoặc nhiều ký tự được ánh xạ làm đầu vào cho các mô hình trong NLP. Trong word embedding, token là chuỗi các ký tự liền kề giữa hai khoảng trắng hoặc giữa dấu cách và dấu chấm.
Blockchain - Token là một loại tài sản kỹ thuật số được phát hành và hoạt động trên một nền tảng Blockchain của các dự án có sẵn mà không sở hữu Blockchain riêng.
. Nó phù hợp với nhu cầu xử lý chuỗi hiệu quả, nhưng việc nén thông tin cũng có thể làm khó khả năng truy xuất một chi tiết cụ thể ở xa.
Sparse Attention
Attention
Có thể dịch nôm là Cơ chế chú ý. Đây là kỹ thuật dựa trên khái niệm về sự chú ý trong nhận thức của con người, kỹ thuật này giúp mô hình tập trung vào những yếu tố đặc biệt nhất định trong dữ liệu.
chỉ tính attention
Attention
Có thể dịch nôm là Cơ chế chú ý. Đây là kỹ thuật dựa trên khái niệm về sự chú ý trong nhận thức của con người, kỹ thuật này giúp mô hình tập trung vào những yếu tố đặc biệt nhất định trong dữ liệu.
trên một tập vị trí được chọn thay vì toàn bộ chuỗi. Trong bản học tập, cứ ba lớp linear sẽ có một lớp sparse; kỹ thuật chọn vị trí được giản lược, không trùng với indexer hay cơ chế KDA trong mô hình sản xuất.
Mixture of Experts: Không phải token nào cũng đi qua mọi chuyên gia
Mixture of Experts (MoE) là kiến trúc gồm nhiều mạng con, thường gọi là experts. Bộ định tuyến (router) quyết định expert nào xử lý token
Token
NLP - Một chuỗi gồm một hoặc nhiều ký tự được ánh xạ làm đầu vào cho các mô hình trong NLP. Trong word embedding, token là chuỗi các ký tự liền kề giữa hai khoảng trắng hoặc giữa dấu cách và dấu chấm.
Blockchain - Token là một loại tài sản kỹ thuật số được phát hành và hoạt động trên một nền tảng Blockchain của các dự án có sẵn mà không sở hữu Blockchain riêng.
. Dự án dùng 8 chuyên gia định tuyến, kích hoạt 2 chuyên gia cho mỗi token
Token
NLP - Một chuỗi gồm một hoặc nhiều ký tự được ánh xạ làm đầu vào cho các mô hình trong NLP. Trong word embedding, token là chuỗi các ký tự liền kề giữa hai khoảng trắng hoặc giữa dấu cách và dấu chấm.
Blockchain - Token là một loại tài sản kỹ thuật số được phát hành và hoạt động trên một nền tảng Blockchain của các dự án có sẵn mà không sở hữu Blockchain riêng.
và có thêm một expert chung.
Cơ chế này giúp tăng dung lượng biểu diễn mà không nhất thiết kích hoạt toàn bộ tham số ở mỗi lần dự đoán. Tuy vậy, việc thiết kế router, cân bằng tải giữa các chuyên gia và tối ưu chạy trên phần cứng đều là những bài toán riêng.
Dự án cũng thử nghiệm bốn luồng residual có thể học. Đây chỉ là bản đơn giản hóa theo ý tưởng manifold-constrained hyperconnections (mHC), không phải hiện thực đầy đủ các ràng buộc toán học của mHC.
3. Mô hình ngôn ngữ có thể học xử lý ảnh như thế nào?
Một LLM
LLM
LLM (Large Language Model), tạm dịch là Mô Hình Ngôn Ngữ Lớn, là một loại mô hình trí tuệ nhân tạo (AI) được thiết kế để hiểu và tạo ra văn bản ngôn ngữ tự nhiên. Những mô hình này thường dựa trên kiến trúc mạng neuron sâu, như Transformer, và được đào tạo trên một lượng dữ liệu văn bản khổng lồ. LLM có khả năng thực hiện nhiều nhiệm vụ liên quan đến ngôn ngữ như dịch thuật, tóm tắt, trả lời câu hỏi, và thậm chí là tạo ra văn bản hoàn chỉnh từ đầu. Những mô hình này đã và đang được sử dụng rộng rãi trong nhiều ứng dụng công nghệ và dịch vụ trực tuyến.
chỉ nhìn thấy token
Token
NLP - Một chuỗi gồm một hoặc nhiều ký tự được ánh xạ làm đầu vào cho các mô hình trong NLP. Trong word embedding, token là chuỗi các ký tự liền kề giữa hai khoảng trắng hoặc giữa dấu cách và dấu chấm.
Blockchain - Token là một loại tài sản kỹ thuật số được phát hành và hoạt động trên một nền tảng Blockchain của các dự án có sẵn mà không sở hữu Blockchain riêng.
văn bản nếu không có nhánh xử lý hình ảnh. Muốn tạo mô hình đa phương thức (multimodal model), chúng ta cần chuyển ảnh thành những vector có thể đưa vào mạng ngôn ngữ.
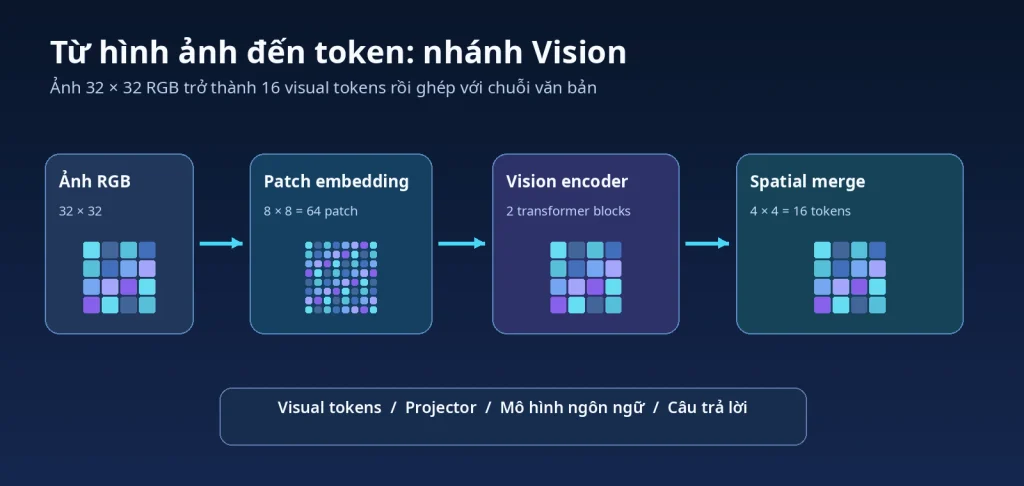
Trong nhánh thị giác của dự án, ảnh RGB kích thước 32 × 32 pixel được chia thành các patch 4 × 4, tạo 64 patch tokens. Hai khối Vision Transformer
Transformer
Transformer là mô hình học sâu được giới thiệu vào năm 2017, được sử dụng chủ yếu trong lĩnh vực xử lý ngôn ngữ tự nhiên (NLP).
xử lý các biểu diễn này, sau đó bước spatial merge gộp chúng thành 16 visual tokens. Một lớp chiếu (projector) đưa đặc trưng
Đặc trưng
Trong học máy và nhận dạng mẫu, một đặc trưng (feature) là một thuộc tính hoặc đặc tính có thể đo lường riêng lẻ của một hiện tượng đang được quan sát.
ảnh về không gian biểu diễn của mô hình ngôn ngữ.
Tác giả kiểm tra nhánh này với ảnh chữ số tổng hợp. Thí nghiệm cho thấy hệ thống có thể học tác vụ nhỏ được thiết kế sẵn, nhưng chưa chứng minh khả năng hiểu ảnh tổng quát hay xử lý ảnh đời thực phức tạp.
4. Huấn luyện mô hình: Pre-training và Reinforcement Learning
Giai đoạn 1: Pre-training để học quy luật dữ liệu
Mô hình được khởi tạo từ trọng số ngẫu nhiên và học dự đoán byte tiếp theo. Với chuỗi đầu vào, hàm mất mát cross-entropy
cross-entropy
cross-entropy thể hiện sự sai khác giữa hai phân bố xác suất, thường được sử dụng trong bài toán phân loại nhiều nhãn.
đo mức chênh giữa phân phối dự đoán và mục tiêu thực tế; quá trình tối ưu liên tục điều chỉnh trọng số để giảm lỗi này.
Tập dữ liệu của dự án gồm các mẫu tổng hợp phục vụ học cú pháp và thao tác lập trình nhỏ. Một điểm được nhấn mạnh là interleaving: xen kẽ nhiều nhóm dữ liệu khi huấn luyện để hạn chế catastrophic forgetting, tức là hiện tượng mô hình suy giảm kiến thức cũ khi học các mẫu mới theo từng đợt.
Giai đoạn 2: Dùng kết quả thực thi làm phần thưởng
Với bài toán sinh mã Python, chúng ta có thể thiết kế phần thưởng tương đối rõ ràng: chạy một đoạn mã với bộ kiểm thử, sau đó đánh giá có vượt qua các trường hợp kiểm thử hay không. Cách tiếp cận này gọi là executable reward, tức phần thưởng dựa trên kết quả chạy chương trình.
Trong phần hậu huấn luyện, dự án sử dụng phương pháp reinforcement learning với nhiều câu trả lời được lấy mẫu cho một yêu cầu. Tín hiệu thưởng được so sánh tương đối giữa các mẫu, theo cách cài đặt RLOO (REINFORCE Leave-One-Out). Các thử nghiệm cũng xem xét nhiệt độ lấy mẫu, số mẫu mỗi nhóm và phạm vi các lớp được cập nhật.
Việc chỉ cập nhật các lớp cuối giúp giới hạn số trọng số cần tối ưu. Nhưng đó cũng là lý do không nên kỳ vọng mô hình nhỏ đột nhiên sở hữu năng lực lập trình phổ quát.
Kết quả đáng chú ý, và điều số liệu chưa nói được
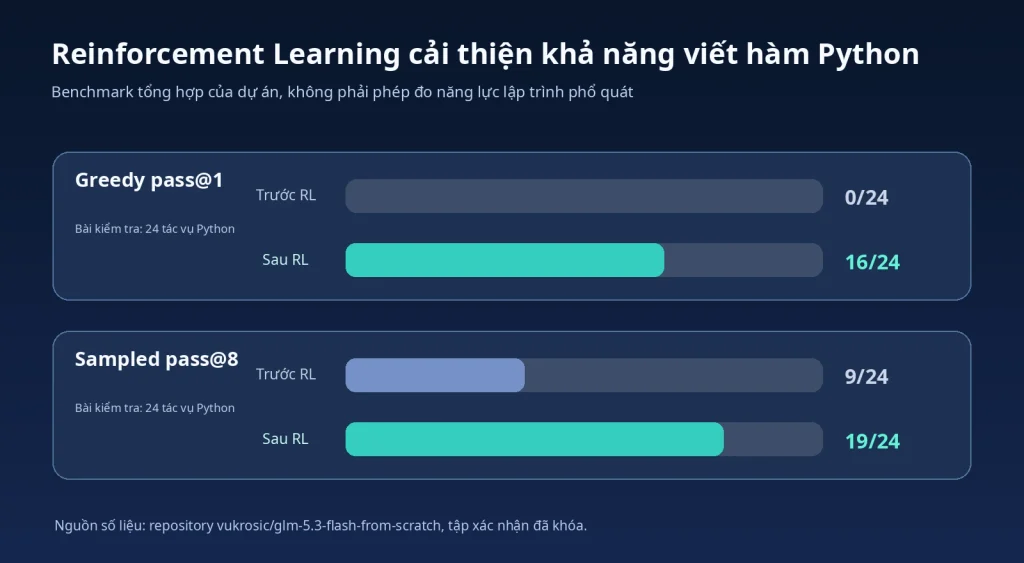
Trong tập xác nhận gồm 24 nhiệm vụ Python thuộc các nhóm đã được huấn luyện, chỉ số greedy pass@1 tăng từ 0/24 lên 16/24. Với tối đa 8 lần sinh cho mỗi nhiệm vụ, số bài có ít nhất một lời giải đạt yêu cầu tăng từ 9/24 lên 19/24.
Đây là minh chứng hữu ích cho việc tín hiệu thưởng dựa trên kiểm thử có thể cải thiện hành vi trong một phạm vi hẹp. Tuy nhiên, báo cáo cũng nêu sự suy giảm ở một số nhóm nhiệm vụ không được RL trực tiếp và việc kết quả thử nghiệm tham số có thể đảo chiều khi thay đổi seed. Do đó, không nên dùng các con số này để khẳng định mô hình viết được Python tốt trên mọi bài toán.
5. Tự chạy dự án bằng Python
Điểm hay của dự án là có mã nguồn để kiểm tra từng lớp, công cụ đánh giá và cả dữ liệu thí nghiệm. Có thể chạy trên CPU
CPU
CPU( Central Processing Unit) là bộ xử lý trung tâm, là các mạch điện tử trong máy, nhiệm vụ của CPU là xử lý thông tin, tính toán các dữ liệu.
, NVIDIA CUDA
CUDA
CUDA viết tắt cho Compute Unified Device Architecture là nền tảng phát triển bởi NVIDIA bao gồm driver cho phần cứng, API và các thư viện tối ưu tính toán trên GPU.
hoặc Apple Silicon MPS. Python 3.12 là lựa chọn được README hướng dẫn vì bộ phiên bản thư viện đã ghim trong dự án.
Trên Windows, lệnh kích hoạt môi trường ảo khác với macOS/Linux; có thể dùng .venv\Scripts\activate trong Command Prompt
Prompt
Prmpt engineering hay prompt (tạm dịch: lời nhắc) là một khái niệm về cách giao tiếp với một hệ thống AI như ChatGPT và nhận được phản hồi mong muốn. Ví dụ: thay vì đưa cho AI một lời nhắc đơn giản như "miêu tả ngôi nhà", bạn có thể thêm thông tin bổ sung vào lời nhắc để có kết quả tốt hơn.
. Việc cài đặt PyTorch phụ thuộc hệ điều hành và cấu hình phần cứng.
Bước 2: Thử một vòng huấn luyện nhỏ trên CPU
Lệnh dưới đây giảm số lớp, số chiều biểu diễn, batch
Batch
Batch là một nhóm (một mẻ, một lô) các mẫu huấn luyện. Việc huấn luyện dữ liệu theo từng lô giúp tăng tốc độ do tận dụng được lợi thế của phép tính ma trận trên GPU.
size và số bước huấn luyện để kiểm tra toàn bộ quy trình hoạt động. Nó chỉ là smoke test, không tạo ra mô hình có chất lượng sử dụng thực tế.
Thư mục đầu ra phải chưa tồn tại khi bắt đầu; nếu đã chạy thử trước đó, hãy dùng tên thư mục khác. Để tái hiện các kết quả 25,7M tham số của tác giả, cần làm theo cấu hình và checkpoint cụ thể trong README, không dùng cấu hình rút gọn phía trên.
Bước 3: Thử nhánh xử lý ảnh
python scripts/train_vision.py \
  --smoke-test --architecture faithful --device auto
Lệnh này kiểm tra đường đi ảnh trên kiến trúc thu nhỏ. Các bước RL, đánh giá tập xác nhận và cấu hình GPU
GPU
GPU là viết tắt của Graphics Processing Unit là bộ xử lý chuyên dụng nhận nhiệm vụ tăng tốc, xử lý đồ họa cho bộ xử lý trung tâm CPU.
được dự án mô tả chi tiết trong README cùng các script riêng.
6. Có nên bắt đầu bằng mô hình 25,7 triệu tham số?
Nếu mục tiêu là hiểu cách một LLM
LLM
LLM (Large Language Model), tạm dịch là Mô Hình Ngôn Ngữ Lớn, là một loại mô hình trí tuệ nhân tạo (AI) được thiết kế để hiểu và tạo ra văn bản ngôn ngữ tự nhiên. Những mô hình này thường dựa trên kiến trúc mạng neuron sâu, như Transformer, và được đào tạo trên một lượng dữ liệu văn bản khổng lồ. LLM có khả năng thực hiện nhiều nhiệm vụ liên quan đến ngôn ngữ như dịch thuật, tóm tắt, trả lời câu hỏi, và thậm chí là tạo ra văn bản hoàn chỉnh từ đầu. Những mô hình này đã và đang được sử dụng rộng rãi trong nhiều ứng dụng công nghệ và dịch vụ trực tuyến.
được xây dựng từ những thành phần cơ bản, đây là dự án đáng nghiên cứu. Bạn có thể đọc nguồn Python, thay đổi tokenizer, số chuyên gia hay tỉ lệ các lớp attention
Attention
Có thể dịch nôm là Cơ chế chú ý. Đây là kỹ thuật dựa trên khái niệm về sự chú ý trong nhận thức của con người, kỹ thuật này giúp mô hình tập trung vào những yếu tố đặc biệt nhất định trong dữ liệu.
rồi quan sát tác động lên loss
Loss
Máy tính học thông qua hàm loss. Đây là một phương pháp đánh giá xem mô hình biểu diễn dữ liệu đã cho tốt đến đâu. Mô hình biểu diễn càng tốt thì giá trị loss càng nhỏ.
và kết quả đánh giá.
Nhưng nếu mục tiêu là tạo chatbot cạnh tranh với sản phẩm thương mại hoặc triển khai AI ở quy mô doanh nghiệp, mô hình giáo dục này không phải lối tắt. Chất lượng ứng dụng phụ thuộc mạnh vào dữ liệu, phân phối bài toán, năng lực phần cứng và quá trình kiểm thử độc lập.
Một dự án như thế này không nhằm chứng minh rằng ai cũng có thể tự tạo phiên bản GLM hàng trăm tỷ tham số trên laptop. Giá trị thật của nó là biến những khái niệm vốn có vẻ xa vời thành mã Python có thể đọc, thử nghiệm và đo lường.